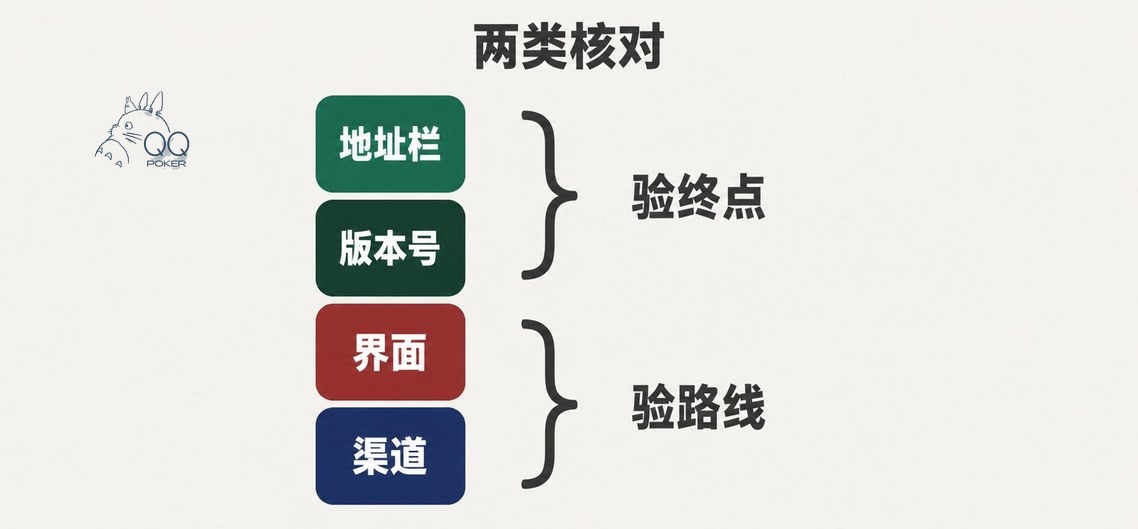
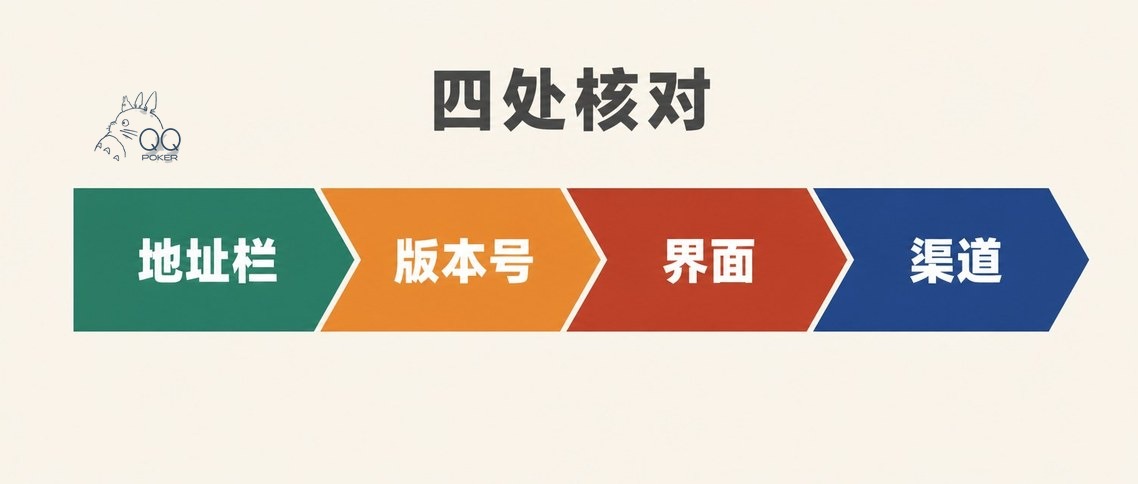
这四处的顺序是故意排的:地址栏最快、代价最低,所以放第一;渠道回溯要翻历史记录,最费时间,所以放最后。前面任何一处没过,后面都不必再做——入口辨识的目的是尽早停下,而不是把四项全走完凑个心安。
看是不是 https,再看地址栏左侧那个锁标有没有带警示色。这一段最容易被忽略,因为它平时一直是对的,反而没人去看。
把主体名一个字母一个字母念出来,尤其是形近的那几对:数字 1 和小写 l、数字 0 和字母 o、rn 连起来像 m。整体扫一眼是认不出来的。
后缀是一段独立的信息,不是主体名的尾巴。两个长度相同的后缀换掉一个字母,整条地址就指向完全不同的地方,但读起来几乎没差别。
主体名对了,后面的路径也要看一眼。路径里塞进别的名字、或者带着一长串看不懂的参数,都说明这一页不是从入口直接进来的。
渠道回溯问的是一个很具体的问题:现在这一页,是从哪一跳过来的?打开浏览器的历史记录,顺着时间往上找两步,如果能看到自己最初点的那个入口,这条路就是清楚的;如果中间冒出一两个自己完全没点过的地址,这一页就不该继续用。

两步是个经验值。只往回看一步,常常只能看到一个跳转页,什么也说明不了;翻超过两步,又会混进当天别的浏览记录。核完之后把确认过的那个地址存成书签,下一次从书签进,整个渠道回溯就省掉了——这也是前面把它排在第四位的原因:它应该越用越少。